Kunden erwarten schnelle Antworten, doch die richtigen Informationen zu finden, ist nicht immer einfach.
In vielen Fällen existiert die Antwort auf eine Kundenfrage bereits – auf einer Website, in einem Produkthandbuch oder in der internen Dokumentation eines Unternehmens. Das Problem besteht darin, dass der Kunde sie nicht findet, während der Mitarbeiter, der helfen könnte, gerade mit anderen Aufgaben beschäftigt ist.
RAG bietet eine praktische Möglichkeit, Informationen leichter zugänglich und auffindbar zu machen. Ein Kunde stellt seine Frage in eigenen Worten und der Assistent antwortet auf Grundlage der vom Unternehmen ausgewählten Materialien. Zeigt die Anwendung zusätzlich die verwendeten Quellen an, können Nutzer nachvollziehen, woher die Antwort stammt. Ein solcher Assistent kann sowohl Kunden auf einer Website als auch Mitarbeiter in einem internen System unterstützen. Dabei wird sichergestellt, dass jede Person nur auf die Informationen zugreifen kann, für die sie eine entsprechende Berechtigung besitzt.
Wofür steht RAG?
RAG steht für Retrieval-Augmented Generation. RAG gehört zum Bereich der künstlichen Intelligenz, genauer gesagt zu den Methoden, die in Verbindung mit generativer KI und Sprachmodellen eingesetzt werden. Das System sucht zunächst nach Informationen, die für die gestellte Frage relevant sind. Anschließend wird ein Sprachmodell damit beauftragt, auf dieser Grundlage eine Antwort zu formulieren. RAG verbindet somit die Suche nach Informationen mit der Generierung von Texten.
Ein Sprachmodell kann man sich wie ein kompetentes neues Mitglied des Kundenservice-Teams vorstellen. Es kann gut kommunizieren, kennt aber unsere Dienstleistungen und internen Regeln noch nicht. Dafür benötigt es die richtigen Informationen, die RAG passend zur jeweiligen Frage auswählt.
Ein Sprachmodell hat nicht automatisch Zugriff auf die aktuellen Inhalte einer Unternehmenswebsite, interne Dokumente oder neue Arbeitsabläufe. Der Nutzer interagiert mit einer konkreten Anwendung oder einem KI-Assistenten, während RAG im Hintergrund mit den Informationen des Unternehmens arbeitet.
Was geschieht nach dem Absenden einer Frage?
Stellen wir uns eine typische Situation vor: Ein Besucher möchte auf einer Website eine bestimmte Dienstleistung buchen. Statt mehrere Unterseiten durchsuchen zu müssen, gibt er seine Frage einfach in einen Chat ein. Im Hintergrund läuft daraufhin ein kurzer Prozess ab:
- Das System findet Abschnitte in den Dokumenten, die mit der Frage zusammenhängen.
- Die ausgewählten Informationen werden zusammen mit der Frage und den Anweisungen zur Formulierung der Antwort an das Modell übermittelt.
- Das Modell erstellt auf Grundlage der bereitgestellten Informationen eine Antwort. Die Anwendung kann außerdem Links zu den verwendeten Quellen ergänzen.
Zunächst müssen die Inhalte entsprechend aufbereitet werden. Dokumente werden in der Regel in kleinere, inhaltlich zusammenhängende Abschnitte unterteilt und in einem Suchindex gespeichert. Neben exakten Schlüsselwörtern kann das System auch nach Texten mit einer ähnlichen Bedeutung suchen. Dafür werden sogenannte Embeddings verwendet. Dabei handelt es sich um numerische Repräsentationen von Texten, mit deren Hilfe das System eine Frage mit den verfügbaren Dokumenten vergleichen kann.
In einer typischen Anwendung bleibt dieser Prozess im Hintergrund. Der Nutzer sieht lediglich seine Frage, die Antwort und gegebenenfalls die Quellen, auf denen die Antwort basiert.
Wie wir RAG in einem Kundenprojekt eingesetzt haben
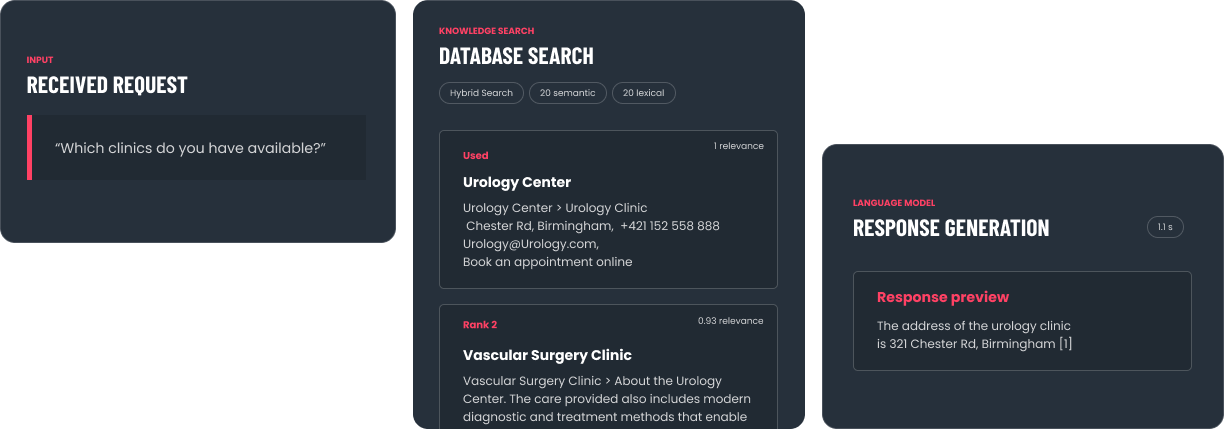
In einem Projekt für eine Privatklinik haben wir einen Assistenten für den Kundenservice entwickelt. Der KI-Assistent arbeitet mit ausgewählten Inhalten der Website der Klinik und nutzt diese, um Fragen zu Dienstleistungen, Kontaktdaten und Terminbuchungen zu beantworten.
Das System sucht auf zwei Arten. Die Stichwortsuche hilft dabei, genaue Bezeichnungen von Dienstleistungen und bestimmte Begriffe zu erkennen. Die semantische Suche ermöglicht es hingegen, natürlich formulierte Fragen zu verstehen. Die Ergebnisse beider Suchverfahren werden zusammengeführt und die relevantesten Abschnitte an das Sprachmodell übermittelt. Das Modell ist angewiesen, ausschließlich auf Grundlage der bereitgestellten Materialien zu antworten und faktische Aussagen mit Links zu den entsprechenden Quellen zu belegen.
Bei der Aufbereitung der Inhalte haben wir die Struktur der Website beibehalten, darunter Überschriften, Absätze und Listen. Bereiche mit Bewertungen und Navigationselementen werden herausgefiltert, damit sie nicht mit Informationen zu den Dienstleistungen und zum Betrieb der Klinik vermischt werden. Schließlich hängt die Qualität einer Antwort auch davon ab, welche Textabschnitte das System findet und an das Modell übermittelt.
So funktioniert RAG technisch
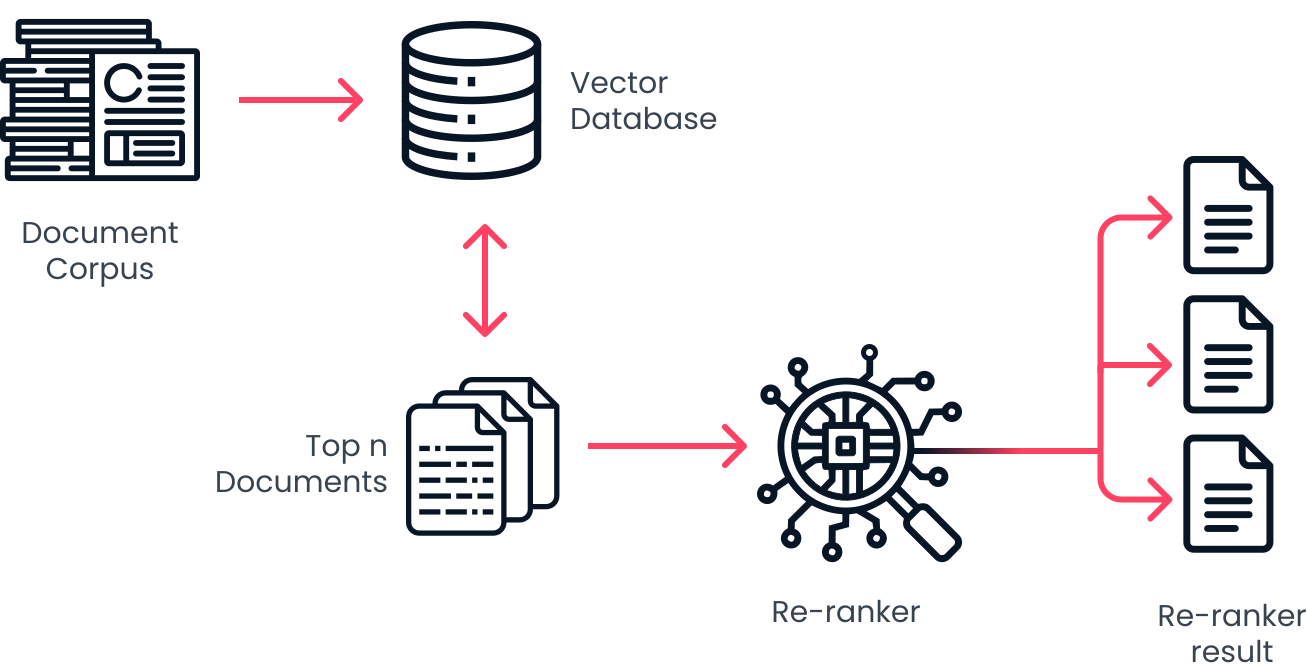
Der gesamte Prozess lässt sich in vier Schritte unterteilen:
- Aufbereitung der Quellen
Zunächst müssen die Quellen vorbereitet werden, aus denen das RAG-System Informationen abrufen soll. Die Inhalte werden in kleinere, inhaltlich zusammenhängende Abschnitte unterteilt und zusammen mit Angaben zu ihrer Herkunft in einem Suchindex gespeichert. Für jeden Abschnitt wird außerdem ein Embedding erstellt – eine numerische Repräsentation seiner Bedeutung. Ändert sich der Inhalt einer Quelle, muss auch der Index aktualisiert werden. - Suche nach relevanten Textabschnitten
Nach dem Absenden einer Frage laufen gleichzeitig zwei Arten der Suche ab. Die erste arbeitet mit Stichwortübereinstimmungen und eignet sich besonders gut, um Namen von Dienstleistungen und Produkten sowie konkrete Begriffe zu erkennen. Die zweite verwendet Embeddings, um die Bedeutung der Frage mit der Bedeutung der gespeicherten Textabschnitte zu vergleichen.
Anschließend werden die Ergebnisse beider Suchverfahren mithilfe von Reciprocal Rank Fusion zusammengeführt. Diese Methode bevorzugt Textabschnitte, die in beiden Ergebnislisten weit oben stehen. Das Modell erhält schließlich höchstens die sechs relevantesten Abschnitte. - Erstellung der Antwort und Ergänzung der Quellen
Die ausgewählten Textabschnitte werden zusammen mit dem Namen der Quelle, dem jeweiligen Bereich, der URL und einer numerischen Quellenmarkierung in die Anweisung für das Sprachmodell aufgenommen. Das Modell soll auf Grundlage dieser Materialien antworten und faktische Aussagen mit den entsprechenden Markierungen kennzeichnen.
Nachdem die Antwort erstellt wurde, behält das Backend nur jene Markierungen bei, die zu den für die konkrete Frage gefundenen Quellen gehören. Dadurch wird verhindert, dass die Antwort auf Quellen verweist, die dem Modell nicht zur Verfügung gestellt wurden. Dennoch muss weiterhin geprüft werden, ob jede Aussage tatsächlich durch die angegebene Quelle belegt wird. - Weiterleitung der Anfrage an ein anderes Tool
RAG arbeitet mit Informationen und generiert Antworten. Soll das System eine konkrete Aktion ausführen, beispielsweise eine bestehende Buchung ändern, benötigt es dafür ein separates Tool und eine Anbindung an die entsprechende Anwendung. In unserer Lösung wird bei einer solchen Anfrage ein Formular angezeigt oder die Anfrage an den Kundenservice weitergeleitet.
Wann lohnt sich der Einsatz von RAG?
RAG ist besonders sinnvoll, wenn Antworten von unternehmenseigenen Informationen abhängen und diese über mehrere Quellen verteilt sind oder regelmäßig aktualisiert werden. Ein typisches Beispiel ist der Kundenservice, der wiederholt dieselben Dienstleistungen und Abläufe erklären muss. RAG kann außerdem Mitarbeitern bei der Suche in internen Richtlinien helfen oder Vertriebsteams bei der Arbeit mit Produktdokumentationen unterstützen.
Ob die Lösung tatsächlich einen Mehrwert bietet, muss im realen Einsatz überprüft werden. Die Anzahl der Gespräche allein zeigt nicht, ob die Nutzer hilfreiche Antworten erhalten haben. Aussagekräftiger ist, wie viele Nutzer die richtigen Informationen gefunden haben, ohne weitersuchen zu müssen, wie schnell sie ans Ziel gelangt sind und bei welchen Fragen weiterhin menschliche Unterstützung erforderlich war.
Manchmal genügt weniger Technologie
RAG ist nicht für jeden Anwendungsfall mit künstlicher Intelligenz erforderlich. Soll ein kurzes Dokument einmalig verarbeitet werden, kann es direkt in die Eingabeaufforderung eingefügt werden. Möchte jemand lediglich eine bekannte Seite finden und öffnen, ist eine herkömmliche Suchfunktion möglicherweise besser geeignet.
Neben RAG können Sprachmodelle auch durch ein Verfahren angepasst werden, das als Fine-Tuning bezeichnet wird. Diese Ansätze dienen jedoch unterschiedlichen Zwecken. Bei RAG erhält das Modell die unterstützenden Informationen in dem Moment, in dem es eine Antwort erstellt. Beim Fine-Tuning wird das Verhalten des Modells anhand von Trainingsbeispielen verändert. Ändert sich ein Unternehmensdokument, muss das generative Modell bei RAG nicht erneut trainiert werden. Stattdessen werden die Quelle und der Suchindex aktualisiert. Beide Ansätze können sich daher ergänzen.
Um den genauen Status einer Bestellung abzurufen, einen Preis zu berechnen oder eine Buchung zu ändern, benötigt eine Anwendung Zugriff auf eine Datenbank oder die entsprechende Schnittstelle. Die Suche nach Textinformationen kann eine solche Aktion nicht ausführen. Sie kann dem Nutzer jedoch den Ablauf erklären und ihn zum passenden nächsten Schritt weiterleiten.
Eine Antwort ist nur so gut wie ihre Quellen
RAG kann unbelegte Antworten reduzieren, aber nicht vollständig verhindern. Die Suche kann einen ungeeigneten Textabschnitt auswählen, während das Modell eine korrekte Quelle unvollständig oder falsch interpretieren kann. Ein Link zu einer Quelle bedeutet nicht automatisch, dass jede Aussage in der Antwort dadurch belegt ist. Deshalb sollten beim Testen die Qualität der Suche und die Qualität der Antwort getrennt bewertet werden.
Die Arbeit mit den Daten endet jedoch nicht an dieser Stelle. Quellen müssen gepflegt und die Lösung anhand von Fragen getestet werden, die Menschen tatsächlich stellen. Wenn RAG mit internen Dokumenten arbeitet, muss das System außerdem die entsprechenden Zugriffsberechtigungen berücksichtigen. Jeder Nutzer darf nur die Informationen erhalten, für die er eine Zugriffsberechtigung besitzt.
Beginnen Sie mit einem konkreten Problem
Ein erfolgreicher RAG-Pilot muss nicht von Anfang an sämtliche Unternehmensinformationen abdecken. Beginnen Sie mit einem Bereich, in dem sich Fragen häufig wiederholen und die Suche nach Antworten Kunden oder Mitarbeiter unnötig belastet. Sammeln Sie zuverlässige Quellen, halten Sie die häufigsten Fragen fest und definieren Sie, was eine hilfreiche Antwort enthalten sollte. Bereits ein erster Test zeigt, ob die Lösung die Suche nach Informationen verkürzen kann und wo noch Verbesserungsbedarf besteht.
Wenn Sie den Einsatz von RAG in Ihrem Unternehmen in Betracht ziehen, sind die Materialien, die Ihre Mitarbeiter bereits zur Beantwortung von Fragen verwenden, ein guter Ausgangspunkt. Mithilfe realer Fragen können Sie schnell feststellen, ob RAG für Ihren konkreten Anwendungsfall einen Mehrwert bietet und welche Funktionen der Pilot enthalten sollte.
Wenn Sie eine Idee für den Einsatz von RAG haben, aber nicht wissen, wie Sie diese umsetzen können, unterstützen wir Sie gerne bei der Bewertung ihres Nutzens und ihrer technischen Machbarkeit. Gemeinsam identifizieren wir das passende Problem, entwickeln eine geeignete Lösung und verwandeln Ihre Idee in eine funktionierende Anwendung, die mit den Informationen Ihres Unternehmens arbeitet.
Kontaktieren Sie uns – gemeinsam bringen wir das Potenzial Ihrer Idee zur Entfaltung.
Kontakt