KI-Lösungen unterscheiden sich bereits in der Entwicklung deutlich von klassischer Individualsoftware. Während bei traditionellen Softwareprojekten Problem, Anforderungen und Geschäftslogik möglichst genau definiert werden, wird das Verhalten eines KI-Systems nicht allein durch den Code bestimmt.
Das Ergebnis hängt zusätzlich vom eingesetzten Modell, vom Prompt, vom verfügbaren Kontext, von der Datenqualität und davon ab, wie Nutzer ihre Anfrage formulieren. Das verändert nicht nur die technische Architektur, sondern auch die Art und Weise, wie KI-Projekte geplant, getestet und betrieben werden.
Ein weiterer Unterschied ist die Vorhersagbarkeit. Klassische Anwendungen folgen klaren Regeln: Wenn Bedingung A eintritt, führt das System Aktion B aus. Bei KI definieren wir dagegen eher das Ziel, den Kontext und die Grenzen, innerhalb derer sich das Modell bewegen soll.
Bei KI reicht es nicht, nur die Funktionalität zu definieren
Bei klassischer Individualentwicklung lässt sich die Funktionalität meist sehr präzise über User Stories und Akzeptanzkriterien beschreiben. Der Nutzer füllt ein Formular aus, das System validiert die Daten, führt eine bestimmte Aktion aus und zeigt das Ergebnis an.
Bei KI reicht eine Anforderung wie „Das System soll Kundenanfragen beantworten“ nicht aus. Zusätzlich muss definiert werden, was eine gute Antwort ausmacht und wie sich das System in Situationen verhalten soll, die nicht eindeutig sind.
Bereits in der Konzeptionsphase müssen deshalb unter anderem folgende Fragen geklärt werden:
- Auf welche Quellen darf die KI zugreifen?
- Welche Informationen muss die Antwort enthalten?
- Welche Informationen darf sie nicht enthalten?
- Wie soll das System mit Unsicherheit umgehen?
- Wann muss eine Anfrage an einen Menschen übergeben werden?
- Welche Fehlerquote ist noch akzeptabel?
Es reicht also nicht zu wissen, was ein KI-Agent tun soll. Ebenso wichtig ist die Frage, wie wir bewerten, ob er seine Aufgabe gut erfüllt.
KI sollte klassische Geschäftslogik nicht ersetzen
Bei KI-Lösungen ist es verlockend, möglichst viele Entscheidungen direkt in den Prompt zu verlagern. In einem Prototyp kann das sehr gut funktionieren, weil das System flexibel und „intelligent“ wirkt. In einer produktiven Umgebung sollten wichtige Regeln jedoch nicht allein dem Modell überlassen werden.
Nehmen wir als Beispiel eine Rückerstattungsanfrage in einem Onlineshop. Die KI kann verstehen, was der Kunde möchte, den Reklamationsgrund zusammenfassen und den nächsten Schritt vorschlagen. Sie sollte jedoch nicht selbst über finanzielle Limits, Berechtigungen oder darüber entscheiden, ob eine Rückerstattung tatsächlich ausgeführt wird. Diese Regeln gehören weiterhin ins klassische Backend, wo sie klar definiert, kontrolliert und nachvollzogen werden können.
Wie KI in einem Geschäftsprozess funktioniert
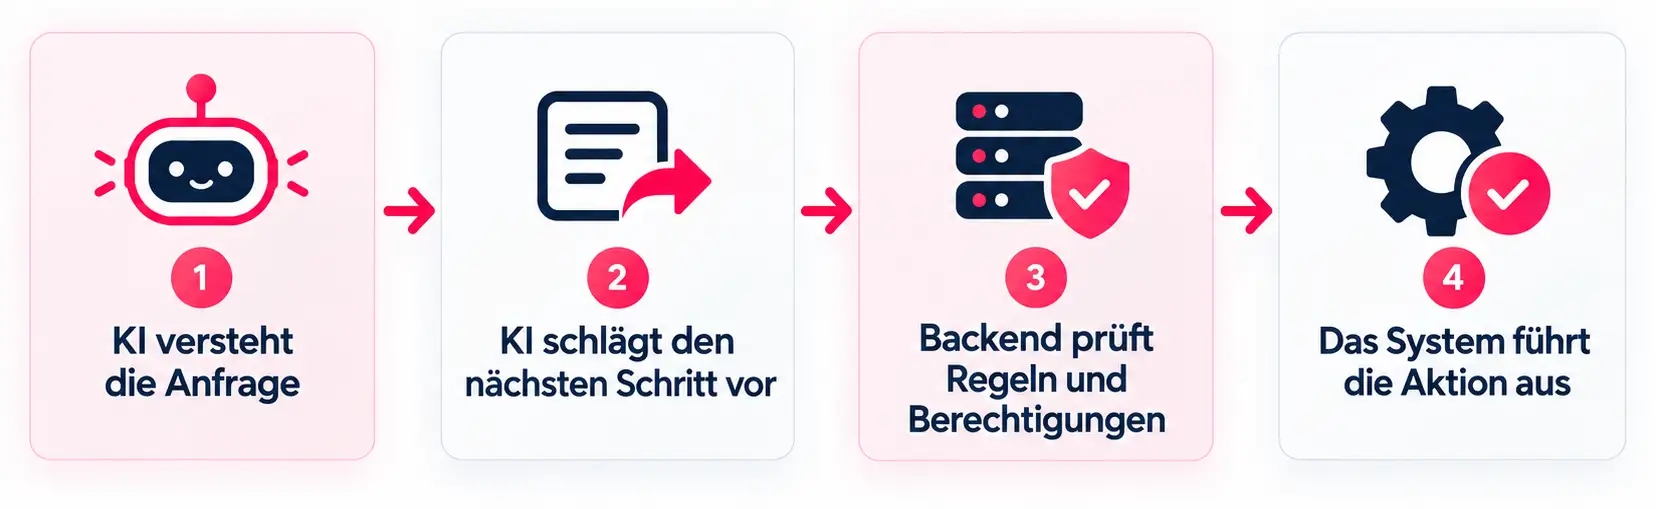
Kl hilft bei der Interpretation und schlägt den nächsten Schritt vor. Regeln und kritische Aktionen bleiben unter der Kontrolle Ihres Systems.
KI sollte also dort eingesetzt werden, wo ihre Stärken liegen: beim Arbeiten mit Text, beim Verstehen von Kontext und bei der Verarbeitung unstrukturierter Informationen. Klassische Software bleibt für Regeln, Kontrollen und kritische Operationen verantwortlich.
KI ersetzt die bestehende Geschäftslogik daher nicht. Vielmehr ergänzt sie diese um eine intelligente Schicht, die besser mit mehrdeutigen Eingaben umgehen und den nächsten Schritt vorbereiten kann.
Daten beeinflussen das Verhalten des Systems direkt
In einer klassischen Anwendung sind Daten in erster Linie Eingaben, auf denen definierte Logik ausgeführt wird. Bei KI bestimmen die Daten zusätzlich mit, wie sich das System verhält.
Wenn eine KI auf Basis interner Unternehmensdokumente antwortet, hängt die Qualität des Ergebnisses davon ab, ob das richtige Dokument gefunden wird, ob es aktuell ist, ob es anderen Quellen widerspricht und ob der Nutzer überhaupt Zugriff darauf haben sollte. Deshalb ist es praktisch unmöglich, eine KI-Lösung zu entwickeln, ohne Themen wie diese zu berücksichtigen:
- Source of Truth,
- Datenqualität,
- Zugriffsrechte,
- Metadaten,
- Retrieval,
- Data Ownership.
Die Qualität der Unternehmensdaten ist besonders bei RAG-Lösungen entscheidend. Selbst ein sehr leistungsfähiges Sprachmodell liefert schwache Ergebnisse, wenn das Retrieval falsche, unvollständige oder veraltete Quellen zurückgibt.
Bei KI gilt daher nicht automatisch: Ein besseres Modell löst das Problem. Oft müssen zuerst die Daten in Ordnung gebracht werden.
Testing ist nicht mehr nur Pass oder Fail
Klassische Software lässt sich anhand klarer Erwartungen testen. Für einen bestimmten Input erwarten wir einen bestimmten Output. Bei KI können mehrere unterschiedliche Antworten korrekt sein, auch wenn sie verschieden formuliert sind. Testing verschiebt sich deshalb von der Prüfung eines einzelnen Werts hin zur Bewertung der Qualität des gesamten Systemverhaltens.
In der Praxis können Teams zum Beispiel folgende Punkte messen:
- faktische Korrektheit,
- Relevanz der Antwort,
- Verwendung der richtigen Quelle,
- Auftreten von Halluzinationen,
- korrekte Tool Calls,
- erfolgreiche Ausführung eines Workflows,
- korrekte Eskalation an einen Menschen.
Dafür werden Evaluation-Datensätze mit realen oder repräsentativen Szenarien erstellt. Eine KI-Lösung wird also nicht nur darauf getestet, ob sie technisch funktioniert. Wir müssen auch verstehen, wie gut sie funktioniert.
Die Entwicklung endet nicht mit dem Go-Live
Bei einer klassischen Anwendung kann auf das Deployment eine relativ stabile Phase folgen. Wenn sich weder Code noch Geschäftslogik ändern, bleibt auch das Verhalten des Systems meist weitgehend gleich.
KI-Systeme sind deutlich dynamischer. Das Modell kann sich ändern, Prompts können angepasst werden, interne Dokumentation wird aktualisiert, die Retrieval-Schicht weiterentwickelt oder Nutzer beginnen, das System auf neue Weise zu verwenden. Selbst kleine Änderungen können die Qualität der Ergebnisse beeinflussen.
Deshalb reicht es bei KI nicht aus, nur Verfügbarkeit, Response Time oder API-Fehler zu überwachen. Zusätzlich sind Metriken wie diese relevant:
- Accuracy,
- Hallucination Rate,
- Tool Success Rate,
- Escalation Rate,
- Latency,
- Cost per Request.
Mit anderen Worten: Neben der technischen Funktionsfähigkeit müssen wir auch überwachen, ob die Lösung korrekt arbeitet, wie viel ihr Betrieb kostet und ob sie sich auch in Szenarien konsistent verhält, die in der Pilotphase nicht aufgetreten sind.
Kosten verhalten sich anders
Bei klassischer Individualentwicklung hängen die Kosten typischerweise vom Entwicklungsumfang, von der Infrastruktur und vom Betrieb ab. Bei KI kommt eine zusätzliche Ebene hinzu, die stärker mit der tatsächlichen Nutzung des Systems verbunden ist. Die Kosten können zum Beispiel abhängen von:
- der Anzahl der Requests,
- der Anzahl der Tokens,
- der Größe des Kontexts,
- dem verwendeten Modell,
- der Anzahl der Tool Calls,
- der Komplexität des Retrievals.
Eine gut konzipierte KI-Architektur optimiert daher nicht nur die Qualität der Ergebnisse, sondern auch die Wirtschaftlichkeit des Betriebs. Nicht jede Aufgabe benötigt das größte und teuerste Modell. Für einfachere Use Cases kann ein kleineres Modell oder klassische Logik effizienter sein, während komplexere Szenarien ein leistungsfähigeres Modell erfordern können.
Auch das Sicherheitsmodell verändert sich
In einer klassischen Anwendung führt der Nutzer Operationen aus, die Entwickler explizit programmiert haben. Ein KI-System kann hingegen mit unstrukturierten Inhalten arbeiten, Anfragen interpretieren und dynamisch entscheiden, welches Tool oder welche API verwendet werden soll. Dadurch entstehen neue Risiken, etwa Prompt Injection, der Abfluss sensibler Daten oder Situationen, in denen die KI zu weitreichende Berechtigungen erhält.
Sicherheit darf deshalb nicht allein auf dem Prompt beruhen. Kritische Kontrollen müssen weiterhin in der Applikations- und Infrastrukturschicht liegen.
Die Sicherheit einer KI-Lösung wird in der Regel durch eine Kombination mehrerer Maßnahmen gewährleistet:
- Least Privilege
Die KI erhält nur Zugriff auf die Daten und Operationen, die sie tatsächlich benötigt. Wenn sie lediglich den Status einer Bestellung lesen soll, sollte sie nicht gleichzeitig berechtigt sein, diese zu ändern oder zu stornieren. - Trennung von Read- und Write-Operationen
Das Lesen von Daten ist weniger riskant als das Ändern von Informationen, das Auslösen einer Zahlung oder das Erstellen einer Bestellung. Sensible Write-Operationen sollten daher zusätzliche Prüfungen durchlaufen. - Authentifizierung und Autorisierung
Die KI darf bestehende Anwendungsregeln nicht umgehen. Über die KI darf ein Nutzer nur auf Daten zugreifen und Aktionen ausführen, für die er auch im ursprünglichen System berechtigt ist. - Human in the Loop
Bei risikoreicheren Operationen kann die KI eine Empfehlung vorbereiten, während die endgültige Freigabe bei einem Menschen bleibt. Das betrifft typischerweise finanzielle Operationen, Änderungen an Kundendaten oder rechtlich sensible Entscheidungen. - Validierung von Inputs und Outputs
Das System kontrolliert, was in das Modell hineingeht und was herauskommt. Dazu können Formatprüfungen, das Filtern sensibler Informationen oder das Blockieren potenziell gefährlicher Anweisungen gehören. - Tool Allowlists und eingeschränkte APIs
Ein Agent sollte keinen uneingeschränkten Zugriff auf alle Systeme erhalten. Er bekommt nur klar definierte Tools und Operationen zur Verfügung, die er tatsächlich verwenden darf. - Audit Logs und Tracing
Bei wichtigen Operationen sollte nachvollziehbar sein, welche Daten das Modell verwendet hat, welche Entscheidung es vorgeschlagen hat, welches Tool aufgerufen wurde und was das System anschließend ausgeführt hat. - Secrets Management
API Keys, Passwörter und Tokens sollten niemals Teil eines Prompts sein oder dem Modell im Klartext zur Verfügung stehen. Sie werden getrennt über sichere Secret Stores und die Applikationsschicht verwaltet. - Isolation und Sandboxing
Wenn KI Code ausführt, mit Dateien arbeitet oder externe Inhalte verarbeitet, sollten diese Operationen möglichst in einer isolierten Umgebung mit eingeschränkten Berechtigungen ausgeführt werden. - Schutz vor Prompt Injection
Externe Dokumente, E-Mails oder Webseiten können Anweisungen enthalten, die das Verhalten des Modells beeinflussen sollen. Deshalb darf externem Inhalt nicht automatisch vertraut werden.
Der zentrale Grundsatz lautet: Das Modell darf nicht zur Sicherheitsinstanz des Systems werden.
Ein Proof of Concept ist einfach – eine produktive Lösung deutlich anspruchsvoller
Ein funktionierender KI-Prototyp kann heute sehr schnell entstehen. Mit relativ wenig Konfiguration kann ein Modell Fragen beantworten, mit Dokumenten arbeiten oder nächste Schritte vorschlagen. Auf den ersten Blick kann dadurch der Eindruck entstehen, dass die Lösung fast fertig ist.
Der Unterschied zeigt sich im realen Einsatz. Eine produktive Lösung muss bei unterschiedlichen Eingaben konsistent funktionieren, die richtigen Daten verwenden, Benutzerberechtigungen respektieren und auch Situationen beherrschen, die während der Prototyp-Phase nicht berücksichtigt wurden.
Beim Übergang in die Produktion müssen Teams deshalb typischerweise folgende Punkte lösen:
- Zuverlässigkeit der Outputs – wie häufig das System korrekt antwortet und wie es mit Unsicherheit umgeht,
- reale Daten – Aktualität, Qualität und Zugriffsrechte,
- Integrationen – sichere Anbindung interner Systeme und Ausführung von Aktionen,
- Fehlerbehandlung und Fallback-Szenarien – zum Beispiel Eskalation an einen Menschen oder Abbruch eines Workflows,
- Monitoring und Evals – kontinuierliche Messung der Qualität nach dem Deployment,
- Kosten und Performance – Latency, Anzahl der Modellaufrufe und Kosten einzelner Operationen.
KI-Entwicklung hat einen anderen Rhythmus
Klassische Individualentwicklung folgt meist einem stärker linearen Prozess. Sie beginnt mit der Analyse, geht über Konzeption, Entwicklung und Testing und endet mit dem Deployment in Produktion. Natürlich können Teams auch hier zu früheren Phasen zurückkehren, das Ziel ist jedoch in der Regel, schrittweise zu einem stabilen Ergebnis auf Basis klar definierter Anforderungen zu gelangen.
KI-Entwicklung ist von Natur aus iterativer. Sie beginnt mit einem konkreten Use Case und den relevanten Daten, gefolgt von einem Prototyp, der kontinuierlich mithilfe von Evals bewertet wird. Auf Basis der Ergebnisse wird die Lösung angepasst, in einem Pilot getestet und nach dem Deployment weiter überwacht und optimiert. Entwicklung, Testing und Verbesserung greifen wesentlich stärker ineinander, weil die Qualität einer KI-Lösung nicht nur vom Code abhängt, sondern auch vom Modell, Prompt, den Daten, dem Retrieval und dem Verhalten der Nutzer.
Klassische Individualentwicklung vs. KI-Entwicklung
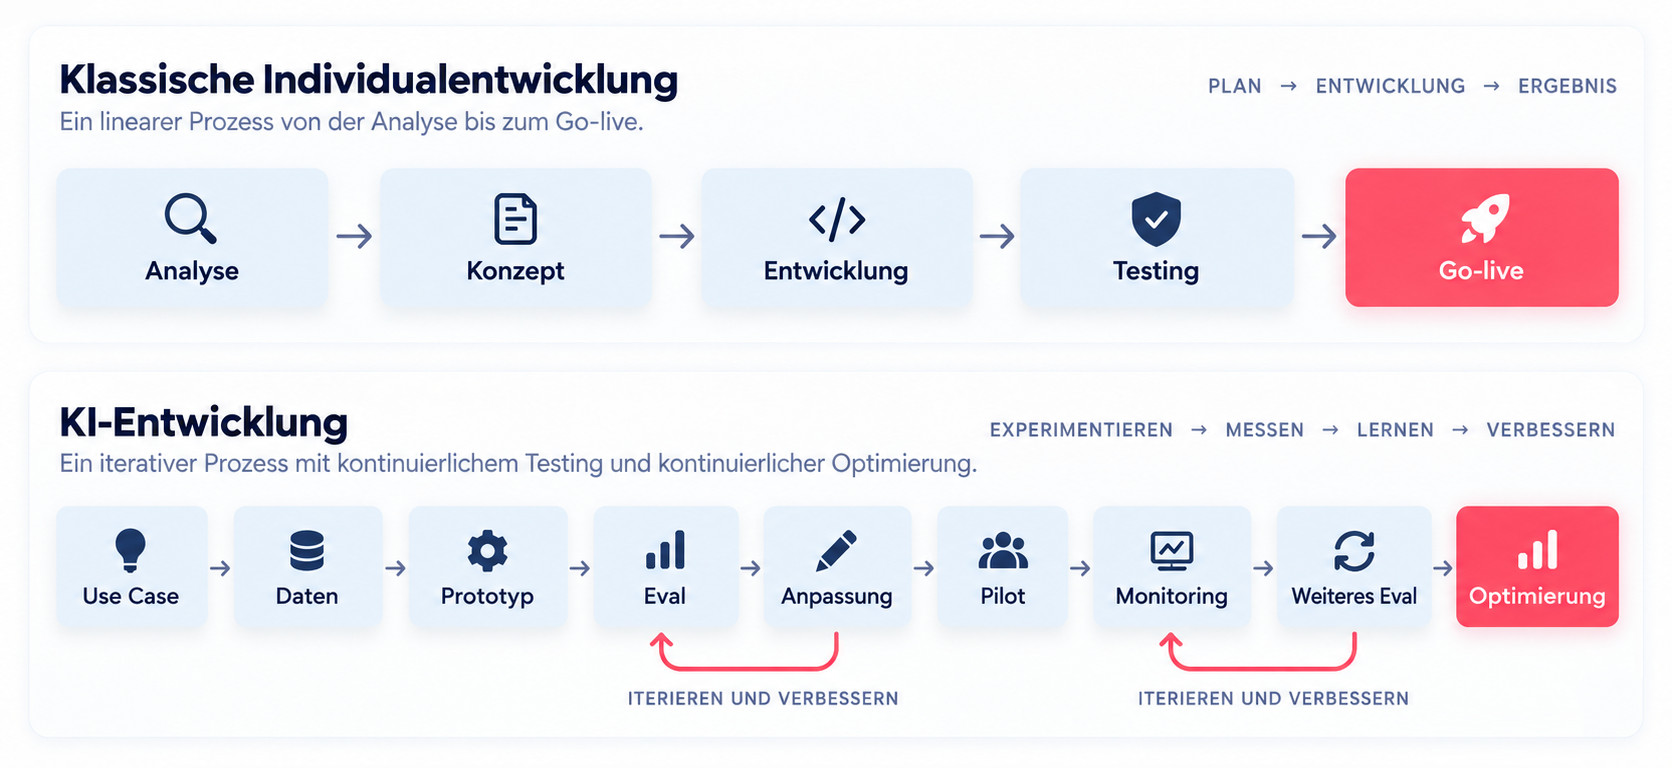
Bei KI-Projekten greifen Entwicklung, Testing und Optimierung deutlich stärker ineinander als bei klassischer Individualentwicklung.
Auch aus Kostensicht werden KI-Lösungen anders betrachtet. Das bedeutet nicht automatisch, dass sie teurer sind. Ein Teil der Kosten verlagert sich jedoch von der einmaligen Entwicklung stärker in Richtung laufender Betrieb und Optimierung.
Bei KI betrachten wir deshalb nicht nur die Implementierungskosten, sondern auch neue Kennzahlen wie Cost per Request, Cost per Task oder Cost per Resolved Case. Dadurch lässt sich besser bewerten, ob die Lösung tatsächlich Zeit spart, manuelle Arbeit reduziert und im Vergleich zum ursprünglichen Prozess einen messbaren Mehrwert schafft.
Planen Sie eine eigene KI-Lösung?
Gerne schauen wir gemeinsam mit Ihnen darauf, wo KI einen echten Mehrwert schaffen kann, wie sie sich in Ihre bestehenden Systeme integrieren lässt und wie eine Lösung aufgebaut sein sollte, die auch für den produktiven Einsatz geeignet ist.
Sie haben einen KI-Use-Case, den Sie von der Idee in die Praxis bringen möchten?
Sprechen Sie uns an.